这模型挺实在,1B参数就能把文档、字幕、翻译一堆事全包了,部署还不费劲。现在连卡证票据都能直接抽字段,对基层办事窗口这类需要快速录入的场景来说,省时省力,值得试试

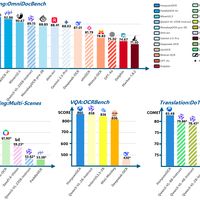
又来了个OCR模型:混元OCR发布并开源github.com/Tencent-Hunyuan/HunyuanOCRHunyuanOCR是一款基于腾讯混元原生多模态架构的端到端OCR专家模型。仅以1B轻
 蚁工厂
 AI为你总结
 问AI
全文概述
腾讯发布了开源的混元OCR模型,基于其多模态架构,仅用1B参数便在多项任务中达到业界领先水平。该模型支持复杂文档解析、文字检测识别、开放字段信息抽取等全场景实用技能,并具备轻量化、易用性和多语种支持等特点。
轻量化架构
混元OCR采用腾讯混元原生多模态架构与训练策略,构建了仅1B参数的OCR专项模型,大幅降低了部署成本,同时保持高性能表现。
全场景功能
单一模型覆盖文字检测和识别、复杂文档解析、卡证票据字段抽取、字幕提取等经典OCR任务,更支持端到端拍照翻译与文档问答,适用于多种应用场景。
极致易用
深度贯彻大模型'端到端'理念,通过单一指令、单次推理即可直达SOTA结果,较传统级联方案更加高效便捷。
多语种支持
支持超过100种语言,在单语种和混合语言场景下均表现出色,满足全球用户的多样化需求。
暂无评论,打开APP参与讨论
 App内打开
